這是一份 7 個人的薪資表,AVERAGE 算出來是 80 萬,MEDIAN 算出來只有 35 萬,差了一倍多。今天來看這兩個數字為什麼差這麼多,再用 MODE、PERCENTILE、QUARTILE 把資料的分布看清楚。
平均數與中位數差在哪?
資料放在 A、B 兩欄,第 1 列是標題:
| 職位 | 年薪(萬) |
|---|---|
| CEO | 200 |
| 技術長 | 150 |
| 業務主管 | 80 |
| 工程師 A | 35 |
| 工程師 B | 35 |
| 工程師 C | 35 |
| 行政助理 | 25 |
先手算。7 個人的年薪加起來是 560,除以 7 得到 80。
再排序找中間那個:25、35、35、35、80、150、200,第 4 個是 35。
用函式算,年薪在 B2:B8:
平均數:全部加起來除以人數
=AVERAGE(B2:B8)中位數:排序後取中間那個值
=MEDIAN(B2:B8)你應該會得到 80 和 35。7 個人裡有 4 個人年薪在 35 萬以下,只有 CEO 跟技術長高過 80 萬,下面這張圖就看得出來:
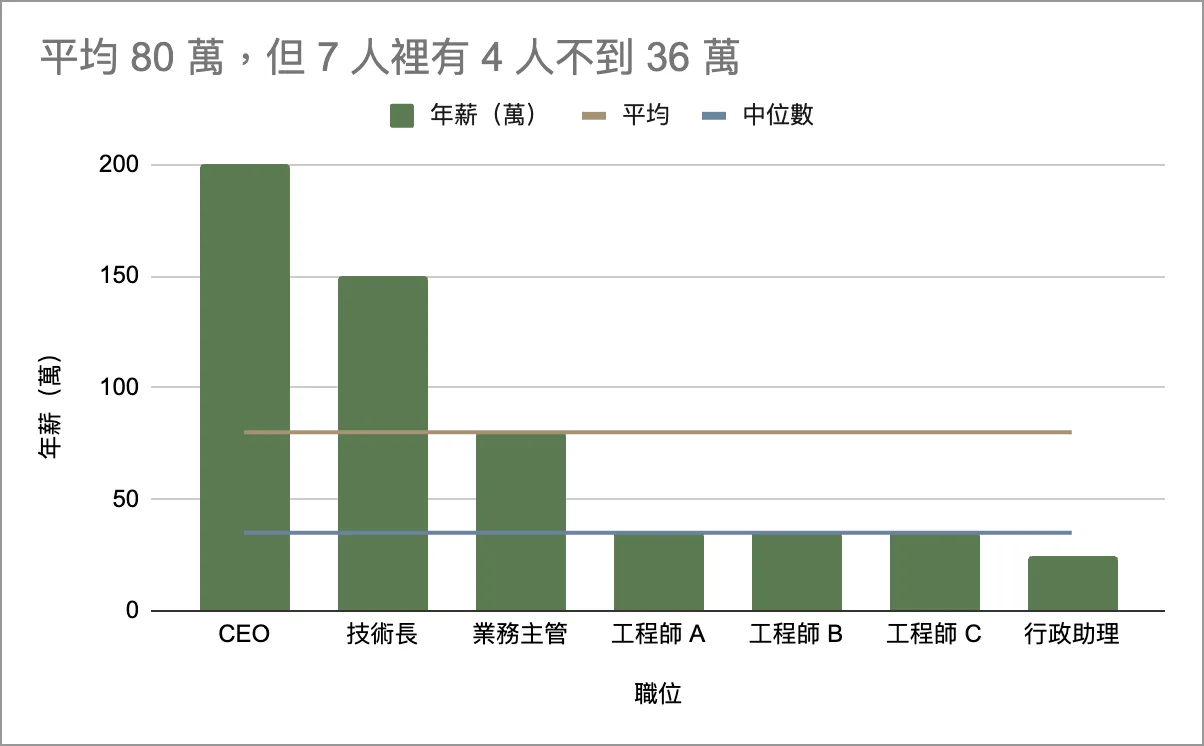
圖:兩個極端值把平均線拉到 80 萬,中位數線 35 萬才貼近大多數人。
我個人看一份新資料,第一個動作是同時算 AVERAGE 跟 MEDIAN。兩個數字差很多,就代表裡面有極端值,這時候用中位數描述「典型」比較準。薪資、房價、訂單金額這類資料特別常遇到。
偶數筆資料的話,MEDIAN 取中間兩個的平均,例如 10 筆成績的中位數是第 5、6 筆的平均。
MODE:最多人選的那個值
眾數是出現最多次的值。這邊拿一份 10 份問卷的 1 到 5 分來看,答案放在 B2:B11:4、5、3、4、4、2、5、4、3、4。
找出出現最多次的數值(眾數)
=MODE(B2:B11)你應該會得到 4,因為 4 分出現了 5 次。同一份資料的 AVERAGE 是 3.8,講「最多人給 4 分」比講「平均 3.8」更有感覺。
要注意,MODE 只吃數值。如果每個值都只出現一次,它會回 #N/A,下一節那 10 筆成績就是這樣。想避開錯誤可以包一層:
沒有重複值時顯示文字,不顯示 #N/A
=IFERROR(MODE(B2:B11),"無眾數")文字資料也一樣,MODE 對尺寸「M」「L」「S」這種欄位會回 #N/A。想知道文字出現最多次的是誰,我通常用 QUERY。假設 A1:A13 是退貨記錄的尺寸欄,標題列加 12 筆資料,M 出現 5 次、L 3 次、S 與 XL 各 2 次:
依尺寸分組計數,次數由高到低排序,只取第一筆
=QUERY(
  A1:A13,
  "select A, count(A)" &
  " group by A" &
  " order by count(A) desc" &
  " limit 1" &
  " label count(A) '次數'",
  1
)
你應該會得到 M 和 5。不想用 QUERY 的話,用 COUNTIF 搭配 INDEX 與 MATCH 也可以,要多包一層 ARRAYFORMULA:
用 COUNTIF 算每個值的出現次數,再找最大次數對應的文字
=ARRAYFORMULA(
  INDEX(
    A2:A13,
    MATCH(MAX(COUNTIF(A2:A13, A2:A13)), COUNTIF(A2:A13, A2:A13), 0)
  )
)PERCENTILE:你贏過幾 % 的人?
這一節把 B2:B11 從上一節的問卷評分改成 10 位同學的成績:92、78、85、63、91、74、88、55、82、69。先排序:55、63、69、74、78、82、85、88、91、92。
PERCENTILE 會回傳一個分數,有指定 % 的資料落在這個分數以下:
第 25 百分位
=PERCENTILE(B2:B11,0.25)第二個參數是 0 到 1 的小數,寫 0.25 代表第 25 百分位。會得到 70.25。
10 筆資料裡沒有剛好第 25% 的那一筆,所以它是插在中間算出來的:第 25 百分位落在排序後的第 3.25 筆,第 3 筆是 69、第 4 筆是 74,69 + 0.25 × (74 − 69) = 70.25。這個插值方式與 Excel 的 PERCENTILE.INC 相同。
同一份資料的 P50 是 80,P75 是 87.25,三條線落在哪裡,看這張圖:
 ← 左右滑動看完整的圖,點圖可放大
圖:百分位線不一定落在某個人的分數上,P25 就卡在 69 與 74 之間。
第二個參數寫成 75 是很常見的錯誤。 會回 #NUM!,要寫 0.75。
我在第幾百分位?
反過來想知道「我考 85 分,贏過班上幾 % 的人」,用 COUNTIF 數比我低的人,再除以總人數。85 分放在 B4:
比 B4 低的人數除以總人數
=COUNTIF(B2:B11,"<"&B4)/COUNT(B2:B11)比 85 低的有 55、63、69、74、78、82,共 6 個人,6 ÷ 10 = 0.6。想直接顯示成文字:
用 TEXT 把小數轉成百分比,組成一句話
="贏過 "&TEXT(COUNTIF(B2:B11,"<"&B4)/COUNT(B2:B11),"0%")&" 的人"你應該會得到「贏過 60% 的人」。
QUARTILE 與 IQR
QUARTILE 是 PERCENTILE 的簡寫版,第二個參數用 0 到 4:
- 是最小值,55。
- 是 Q1,等同
PERCENTILE(B2:B11,0.25),70.25。 - 是中位數,80。
- 是 Q3,87.25。
- 是最大值,92。
這五個數字剛好就是箱形圖需要的材料。Google 試算表沒有原生的箱形圖,不過可以用「蠟燭圖」湊出來:低點放最小值、開盤放 Q1、收盤放 Q3、高點放最大值,箱子就是 Q1 到 Q3。
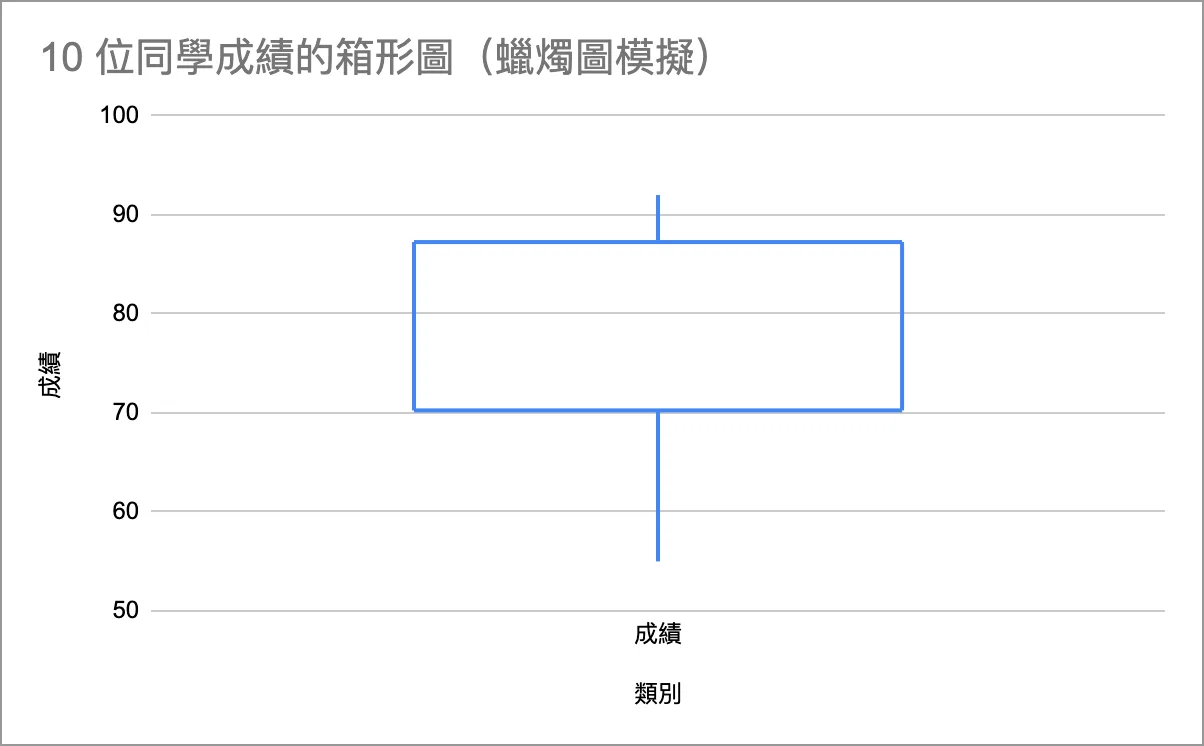
圖:箱子是中間 50% 的同學,中位數 80 另外標在箱子裡。
Q3 − Q1 叫做 IQR(四分位距),這份成績是 87.25 − 70.25 = 17。統計上常用 IQR 抓異常值,邊界是:
- 下界:Q1 − 1.5 × IQR
- 上界:Q3 + 1.5 × IQR
成績的邊界是 44.75 和 112.75,沒有人超出去,所以這份成績沒有異常值。接下來暫時把 B2:B11 的成績替換成另一份資料:10 筆訂單金額(元),依序填入:120、150、200、180、99、5800、160、140、175、130。
Q1 是 132.5,Q3 是 178.75,IQR 是 46.25,邊界是 63.125 和 248.125,5800 超出上界,其他都在裡面:
 ← 左右滑動看完整的圖,點圖可放大
圖:鬚只畫到邊界內最遠的值,超出邊界的 5800 單獨標出來。
把 Q1、Q3、邊界先算在儲存格裡,公式比較好讀:
E2放 Q1:E3放 Q3:E4放 IQR:E5放下界:E6放上界:
接著在 C2 判斷第一筆訂單,往下拉到 C11:
E5、E6 算好之後,C2 判斷第一筆訂單,往下拉
=IF(B2>$E$6,"異常高",IF(B2<$E$5,"異常低","正常"))C2:C11 只有 5800 那一列會顯示「異常高」。
這個判斷有它的限制。前面 7 個人的薪資 Q1 是 35、Q3 是 115,上界 235,200 萬的 CEO 反而不算異常值。IQR 只是一個常見的參考線,要不要用 2 倍、3 倍,或是直接用業務邏輯判斷,看你的資料而定。
次數分配
先把 B2:B11 從訂單金額還原為成績,依序填回 92、78、85、63、91、74、88、55、82、69。確認共有十個分數,再做以下次數分配;不要沿用含 5800 的金額資料。
最後看成績落在哪個區間。用 COUNTIFS 數每個區間的人數,條件成對寫,同一個範圍可以重複出現:
60 到 69 分的人數:大於等於 60 且小於 70
=COUNTIFS(B2:B11,">=60",B2:B11,"<70")最下面的 90 分以上只要一個條件:
90 分以上的人數
=COUNTIFS(B2:B11,">=90")5 個區間算出來是 1、2、2、3、2 人,合計 10 人,對得起來。畫成柱狀圖,分布就一目了然:
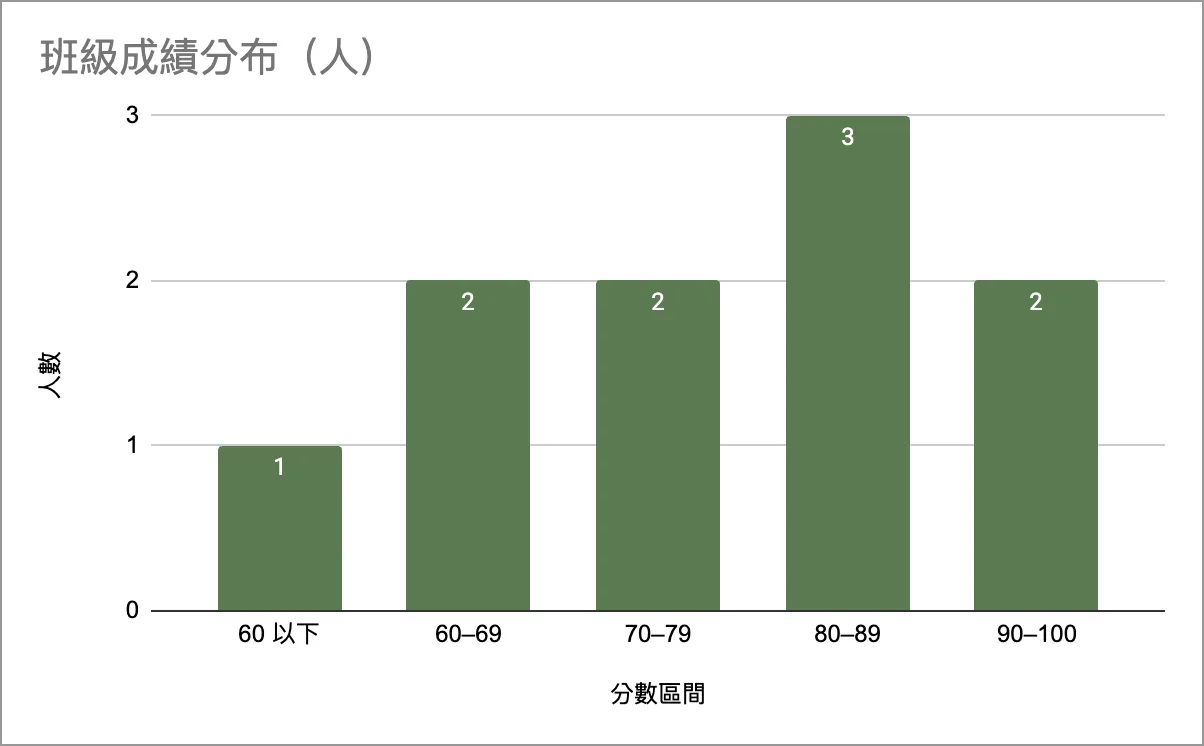
圖:80 到 89 分的人最多,有 3 人。
動手練習
平均還是中位數
外送平台記錄了 8 筆等候時間(分鐘):18、22、25、20、19、95、24、21。請算出 AVERAGE 與 MEDIAN,哪一個比較能代表「平常要等多久」?
算百分位排名
20 個人參加測驗,成績放在 B2:B21,你的成績 82 分放在 C1,其中有 14 個人低於 82 分。請寫出算你百分位排名的公式,結果是多少?
找邊界
已知 Q1 = 45,Q3 = 75,請問異常值的下界、上界各是多少?110 是異常值嗎?
測驗
統計分析函式測驗
一組房價資料中有幾筆豪宅成交記錄,平均值遠高於大多數房子的價格。要代表「典型房價」,應該用哪個函式?
用這幾個函式看過資料的分布,再決定要報平均還是中位數,通常比只看一個數字可靠。想看排名的做法可以接著看 計算排名與百分位,區間計數的細節在 SUMIF 與 COUNTIF。
我是喜特先生,Mr. Sheet,我們下個教學見!

接下來可以
這篇在技能樹的 Lv.2「進階分析」,模組「分析資料的分布」(第 1/1 篇)。讀完這篇,路線上的下一個模組是「用顏色標示資料」。
回到技能樹相關文章
查看所有文章留言討論
共 0 則留言